AIファクトリーの規模がメガワット、ギガワット単位へ拡大するにつれ、次の制約は「どうつなぐか」に移っている。NVIDIAとCiscoは2026年10月12日、AIファクトリー向けの新しい高密度プラガブル光モジュール「USFP」の計画を発表した。GPUがどれほど高性能でも、つなぐ“道”が詰まれば、クラスタ全体の実効性能は伸びない。
| この記事のポイント ■ NVIDIAとCiscoは2026年10月12日、AIファクトリー向けの高密度プラガブル光モジュール「USFP」の計画を発表した ■ USFPは1レーンあたり400Gb/sに対応し、最大12.8Tb/sの容量を可能にすると説明されている ■ 200Gb/s per laneの光モジュールと比べ、帯域密度は4倍、電力効率は約1.3倍になる見込み(両社の説明) ■ 両社はUSFPのオープンな業界仕様をつくる計画で、TE ConnectivityとAmphenolとも連携する ■ 今回の発表は新しい規格(フォームファクター)の計画であり、量産採用が完了したという意味ではない |
ひとことで言うと
AIの計算力を伸ばすには、GPU同士・ラック同士を大量のデータが行き交う“光の道”を太くする必要がある。USFPは、抜き差しできる光モジュールの使い勝手を保ったまま、その道を一気に太くしようという新しい規格の構想である。
何が発表されたのか
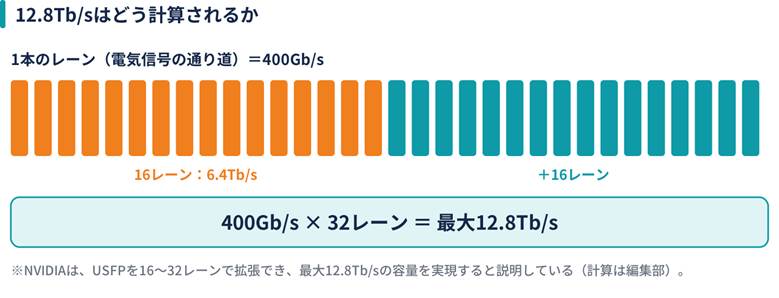
NVIDIAとCiscoは10月12日、AIファクトリー向けの新しい光モジュールの形状(フォームファクター)「USFP(Ultra-Dense Small Form Factor Pluggable)」を発表した。1レーンあたり400Gb/sの信号に対応する高密度の光モジュールで、最大12.8Tb/sの容量を可能にするという。
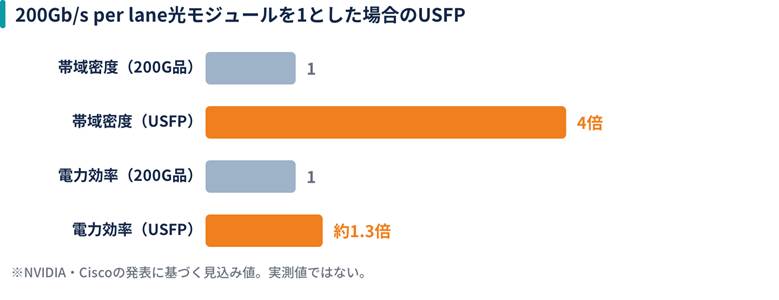
両社によると、USFPは200Gb/s per laneの光モジュールと比べて帯域密度が4倍、電力効率が約1.3倍になる見込みだ。両社はUSFPのオープンな業界仕様をつくる計画を示し、コネクタ大手のTE ConnectivityやAmphenolとともに、複数の企業が部品を供給できるエコシステム(マルチソース)を築くとしている。
出典:各社・各団体の公表資料をもとにSEMICON.TODAY編集部作成
出典:各社・各団体の公表資料をもとにSEMICON.TODAY編集部作成
基礎から理解する:なぜ“つなぐ力”が性能を決めるのか
AIの処理を種類別に見ると、光接続の重要性がよくわかる。学習(Training)では、多数のGPUが計算途中の結果を頻繁に交換する。推論(Inference)では大量のリクエストを素早く処理する。RAGでは検索用データベースやストレージから情報を引き出し、Agentic AIでは検索、推論、コード生成、検証を繰り返す。どの処理でも、計算そのものに加えてデータの移動量が性能とコストを左右する。
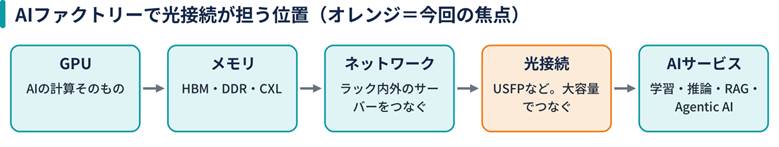
出典:各社・各団体の公表資料をもとにSEMICON.TODAY編集部作成
USFPとCPOは何が違うのか
光接続には大きく2つの方式がある。1つはUSFPのような「プラガブル(抜き差しできる)」方式。光モジュールをスイッチの前面から差し込んで使い、故障したら1本ずつ交換できる。もう1つは「CPO(Co-Packaged Optics)」で、スイッチの頭脳であるASICのすぐ隣に光エンジンを置き、電気配線を短くして電力効率を高める。
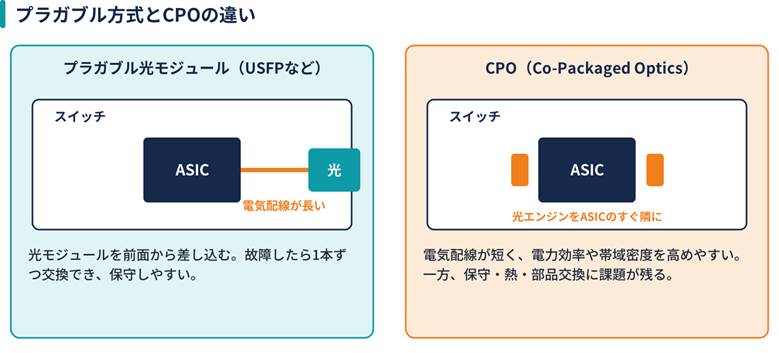
出典:各社・各団体の公表資料をもとにSEMICON.TODAY編集部作成
保守性を重視するデータセンターでは、プラガブル方式の運用実績が大きい。CPOとUSFPは、どちらかが短期間でもう一方を置き換えるというより、用途や距離、冷却、保守の方針に応じて併存する可能性が高い。
日本企業への示唆
USFPが普及すれば、光部品、レーザー、DSP(信号処理チップ)、ドライバ、TIA(受光信号の増幅回路)、コネクタ、基板材料、熱対策部材、光計測に需要が波及する。400Gb/s per lane級では、信号品質、熱、実装精度の要求が一段と厳しくなる。GPUやHBMの“外側”にある光接続・精密部材・検査は、日本企業にとって商機を読むべきテーマである。
注意すべき点
今回の発表は新しいフォームファクターの計画であり、量産品の出荷時期は示されていない。両社はオープンな業界仕様をつくる計画を示した段階で、すべてのAIファクトリーで採用が決まったわけではない。
帯域密度4倍、電力効率約1.3倍という数値は、200Gb/s per laneの光モジュールとの比較で両社が示した見込みである。実際の性能は、製品化後の評価で確認する必要がある。
まとめ
NVIDIAとCiscoのUSFP構想は、AIファクトリーの制約がGPUやHBMだけでなく光接続へ広がっていることを示す。400Gb/s per lane、最大12.8Tb/sという方向性は、ラック規模・クラスタ規模でAIの計算を拡大するためのインフラ技術である。
光接続、CPO、プラガブル、基板、熱、検査を含む周辺技術が、AI半導体ブームの次の焦点になる。
用語解説
| 用語 | 説明 |
| USFP | Ultra-Dense Small Form Factor Pluggableの略。NVIDIAとCiscoが発表したAIファクトリー向け高密度プラガブル光モジュールの構想。 |
| プラガブル光モジュール | スイッチやサーバーに差し込んで使う、交換可能な光通信モジュール。保守性と柔軟性に強みがある。 |
| レーン | 信号を送る通り道の単位。1レーンあたりの速度×レーン数で総容量が決まる。 |
| CPO | Co-Packaged Opticsの略。スイッチASICと光エンジンを近接配置し、電力効率や帯域密度を改善する実装方式。 |
| 帯域密度 | 一定の面積や体積あたりに確保できる通信容量。 |
| AIファブリック | AIクラスタ内でGPU、CPU、NIC、ストレージを接続するネットワーク基盤。 |
出典(Sources)
本文での主な参照箇所:USFP、400Gb/s per lane、最大12.8Tb/s、帯域密度4倍・電力効率約1.3倍、オープン仕様、TE Connectivity・Amphenol
・S2|Cisco|Cisco Advances Scalability and Openness at OCP 2026|2026-10-12
本文での主な参照箇所:USFP、Cisco Silicon One、OCP文脈
本文での主な参照箇所:USFPが16〜32レーンで拡張可能
※本記事は各社・各団体の公表資料および報道をもとに作成したものであり、特定の銘柄の売買を推奨するものではありません。記載内容は執筆時点の公開情報に基づきます。