
| この記事のポイント ✓ AI推論チップの新興企業d-Matrixは9月10日、次世代チップ「Raptor XPU」をNVIDIAのMGXラックにNVLink Fusionで統合する複数年の協業を発表 ✓Raptorは2026年末までのテープアウト(設計完了)を予定し、MGXラック統合版の初期提供は2027年第4四半期の見込み。量産開始の発表ではない ✓推論を「読み込み(Prefill)」と「生成(Decode)」に分け、前者をNVIDIAのGPU、後者を低遅延特化のXPUが担う「分業」構成を提案✓NVIDIAの接続規格が他社チップに開放されたことで、競争の軸はチップ単体の性能から「NVIDIAのラックにどう入り込むか」へ移りつつある |
2026年9月10日、AI推論チップを開発する米新興企業d-Matrixは、NVIDIAとの複数年にわたる協業を発表した。次世代の推論用チップ「Raptor XPU」を、NVIDIAの高速接続技術「NVLink Fusion」を使って同社のラック標準「MGX」に統合する。Raptorは2026年末までにテープアウト(設計を完了し製造に回す工程)を迎える予定で、MGXラックに統合された初期システムの提供は2027年第4四半期が見込まれている。
この発表の面白さは、AI推論チップの競争が「チップ単体の速さ」から「NVIDIAのAIファクトリーの中でどの役割を担うか」へ移ったことを示す点にある。NVIDIAは自社の接続技術NVLinkを他社のCPUやアクセラレータにも開放する「NVLink Fusion」を進めており、d-Matrixはその枠組みに乗る形で、GPUと共存する推論チップという立ち位置を選んだ。
本稿では、推論の仕組みとPrefill/Decodeの分業、発表の正確な時間軸、NVIDIAエコシステムに入る意味、日本企業への示唆を解説する。
そもそもd-Matrixとは
米カリフォルニア州サンタクララのAI推論チップ企業。メモリと演算を近づける「メモリ中心設計」を特徴とし、現行製品のCorsairはすでに量産段階にある。次世代のRaptorは、DRAMチップとSRAM演算チップを縦に重ねる独自の3D積層技術を採用し、2026年8月のHot Chips会議で技術を初公開した。100件超の特許を持ち、大手クラウドやAI研究機関で評価が進んでいるという。
1. 基礎:生成AIの推論は「読み込み」と「生成」の2段階
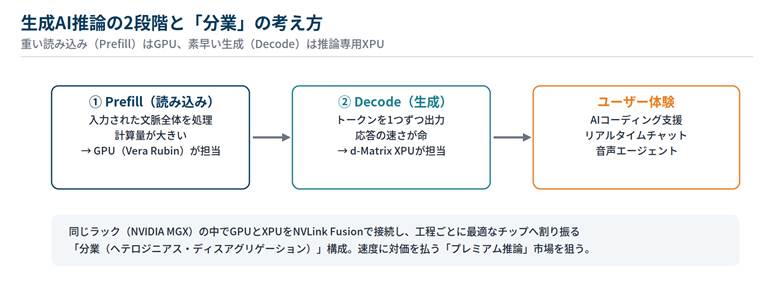
図1:PrefillとDecodeの分業。重い読み込みはGPU、素早い生成はXPUへ
生成AIが質問に答えるとき、処理は大きく2段階に分かれる。第1段階のPrefill(プリフィル)は、入力された文章や文脈全体を読み込む処理で、大量の並列計算が必要になる。第2段階のDecode(デコード)は、回答のトークンを1つずつ順番に生成していく処理で、計算量よりも「次の1語をどれだけ速く出せるか」という応答遅延が重要になる。
d-Matrixが提案するのは、この2段階を異なるチップで分業する構成だ。計算力で勝るNVIDIAのGPU(次世代のVera Rubin)がPrefillを担い、メモリを演算のすぐ隣に置いたd-MatrixのXPUが低遅延のDecodeを担う。AIコーディング支援、リアルタイムチャット、音声エージェントのように、応答の速さに顧客がお金を払う「プレミアム推論」市場が狙いである。同じラックの中で工程ごとに最適なチップへ処理を割り振るこの考え方は、「分業型(ディスアグリゲーテッド)推論」と呼ばれ、NVIDIA自身も推進している。
やさしく解説:なぜ応答の速さが「別売り」になるのか
人間との対話やコード補完では、回答全体の生成時間よりも「打てば響く」感覚が体験を決める。1トークンあたりの生成間隔が短いサービスは、同じモデルでも高い料金を設定できる。推論インフラの世界では、速度がそのまま価格帯(プレミアムティア)になるという商売の構造が生まれつつあり、低遅延特化チップの市場はその上に成り立つ。
2. 発表の中身と時間軸:これは「量産開始」ではない
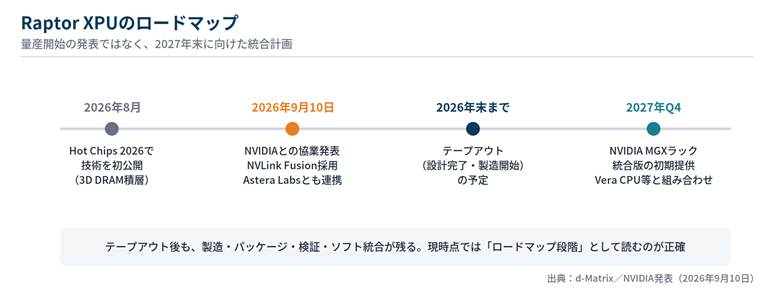
図2:Raptorのロードマップ。2027年Q4のラック統合版提供に向けた計画段階
時間軸を正確に押さえたい。Raptorはまだシリコン(実チップ)が存在しない。2026年末までのテープアウトの後、製造、パッケージ組立、動作検証、ソフトウェア統合、システム認定という工程が残る。MGXラック統合版の初期提供は2027年第4四半期の見込みであり、本発表は量産開始ではなく、複数年ロードマップの合意である。
構成要素は具体的に示されている。最初の製品はNVIDIAのMGXリファレンス設計に基づくラックで、NVIDIAのVera CPU、NVLinkスイッチ、BlueField-4 DPU、ConnectX-9 SuperNIC、Spectrum-X Ethernetを組み合わせ、そこにRaptor XPUが収まる。ラック内の高速接続(スケールアップ)はNVLinkが、ラック間の接続(スケールアウト)はEthernetが担う二層構造だ。接続半導体のAstera LabsもNVLink Fusion陣営として協業に加わる。
3. 技術的意味:NVLink Fusionが変える競争の構図
NVLink Fusionは、これまでNVIDIA製品専用だった高帯域接続NVLinkを、条件を満たす他社チップに開放する仕組みである。d-Matrixにとっての価値は明確だ。カスタムチップをAIファクトリー規模で量産に持ち込むには、接続規格、ラック設計、電源、液冷、ネットワーク、サプライチェーンをすべて自前で検証する必要があるが、成熟したMGXエコシステムに乗ればその時間とリスクを大幅に削れる。
一方でこれは、NVIDIAのプラットフォーム支配が「GPUを売る」段階から「ラックとエコシステムを胴元として提供する」段階へ進んだことも意味する。推論チップの新興企業は、NVIDIAと正面から戦うか、NVIDIAのラックの中で役割を確保するかの選択を迫られる。d-Matrixは後者を選び、MediaTekなど他のNVLink Fusion参加企業もそれぞれの持ち場を探っている。競争の軸は「単体のTOPS(演算性能)」から「どのラックで、どのGPUと、どのネットワークで動くか」へ移った。
4. 製造・材料面:3D積層は実装技術の総合戦
Raptorの技術的な特徴は、DRAMチップとSRAM演算チップを2階建てに重ねる3D積層(3D DRAM stacking)にある。メモリと演算の物理的距離を縮めることで、Decodeに効く低遅延と電力効率を狙う設計だ。詳細な製造プロセスや歩留まりは公開されていないが、この方向性は接合、積層、熱管理、検査、電源設計の難度を確実に高める。
日本企業には、ここに関与の余地がある。チップ同士を重ねるハイブリッドボンディングや接合材料、積層後の熱を逃がす熱伝導材料、薄化したチップの検査、プローブカード、実装装置、基板。推論特化チップが多様化するほど、先端実装と信頼性評価の需要は広がる。また、テープアウト後の量産にはファウンドリと先端パッケージングの枠の確保が必要であり、その供給網は既存のAIチップと同じ日本の材料・装置の上に成り立つ。
5. 注意点:ロードマップ段階の発表として読む
注意点を整理する。第一に、Raptorには量産実績も大規模稼働データもまだない。テープアウト前の段階での性能の主張は、実チップとソフトウェアの成熟を経て初めて検証される。第二に、NVLink Fusion採用はGPUの置き換えを意味しない。d-Matrix自身が、GPUとXPUの併存・分業を前提に設計している。第三に、2027年Q4という時期も「見込み」であり、半導体開発では設計や検証のやり直しで時期が動くことは珍しくない。
正確な読み方はこうだ。Raptor XPUは、NVIDIAのAIファクトリーの中で低遅延推論を担う有力候補であり、その実現性は2026年末のテープアウトと2027年の検証で順次確認されていく。発表は競争構図の変化を示すシグナルとして重要だが、確定した製品計画として部材需要を見積もるのはまだ早い。
推論チップの勝負は「ラックの中の指定席」争いへ
d-MatrixとNVIDIAの協業は、AI推論チップの競争がラック統合の時代に入ったことを示す。推論の価値は、チップ単体の演算性能ではなく、GPU、XPU、CPU、ネットワークをどう接続し、低遅延でトークンを出し続けられるかで決まる。
NVLink Fusionという「開かれた接続」の登場で、新興チップ企業にはNVIDIAエコシステム内の指定席を争う道が開けた。日本企業にとっては、多様化する推論チップの実装・接合・熱・検査こそが、確度の高い商機である。
用語解説
| 用語 | 解説 |
| XPU | GPU・CPU以外も含むアクセラレータの総称。d-Matrixの場合はAI推論向けの専用チップを指す。 |
| NVLink Fusion | NVIDIAの高帯域接続技術NVLinkを、他社のCPUやアクセラレータにも開放する仕組み。半カスタムのラック構築を可能にする。 |
| MGX | NVIDIAのサーバー・ラックのリファレンス(参照)設計。これに準拠すれば、電源・冷却・ネットワークを含む設計と供給網を共通化できる。 |
| Prefill/Decode | 生成AI推論の2段階。Prefillは入力文脈の読み込み(計算量重視)、Decodeはトークンの逐次生成(低遅延重視)。 |
| テープアウト | チップの設計を完了し、製造(マスク作成)に回す節目。ここから量産までにはさらに1年前後の工程が残る。 |
| 分業型(ディスアグリゲーテッド)推論 | PrefillとDecodeを別々のハードウェアに割り当て、それぞれを最適化する推論の構成方法。 |
| 3D積層 | チップを縦に重ねて接続する実装技術。Raptorはメモリ(DRAM)と演算(SRAM)チップの2階建て構造を採用する。 |
| DPU/SuperNIC | データセンター内の通信・セキュリティ処理を専用に担うチップ。NVIDIAのBlueField、ConnectXが代表例。 |
参考リンク(出典)
- d-Matrix:d-Matrix Adopts NVIDIA NVLink Fusion Rackscale Infrastructure for Ultra-Low Latency AI Inference(2026年9月10日)
- PR Newswire:同リリース
- NVIDIA Blog:d-Matrix Adopts NVIDIA NVLink Fusion for Rack-Scale XPU Deployment(2026年9月10日)
- StorageReview:d-Matrix Raptor XPUs Join NVIDIA MGX Racks Through NVLink Fusion, With First Systems Due Q4 2027
本記事は公開情報(各社プレスリリース、決算資料、報道)に基づき、SEMICON.TODAY編集部が作成した。
数値は発表時点のものであり、為替換算は概算。投資判断の勧誘を目的とするものではない。
-
求人
プロセッサ・マイクロコントローラ この分野に関連する最新の求人情報はこちら›
-
求人
デジタルIC設計 この分野に関連する最新の求人情報はこちら›
-
求人
後工程プロセス開発 この分野に関連する最新の求人情報はこちら›


